先说结论:扒完源码,我认为 Prompt Optimizer 这 3.5 万 star 的含金量,大头在工具链,不在「优化」这个动作本身——所谓优化,核心就是一段写得很讲究的元提示词;真正值钱的是它把改写、测试、评估、对比、迭代做成了一条顺手流水线,而且整条流水线跑在你自己的浏览器里。
我平时给 Agent 调 system prompt,经常陷进一个循环:写一版,跑一下,输出跑偏,回去再改。改到第五六版,哪版效果最好已经记不清了。看到这个项目 star 涨到 3.5 万多(2026-09-24 通过 GitHub API 实查),我决定先不急着用,把 develop 分支的源码翻一遍,看看「优化提示词」这件事它到底是怎么做的。
| 项目名片 | 信息 |
|---|---|
| 项目地址 | github.com/linshenkx/prompt-optimizer |
| 主要语言 / License | TypeScript / AGPL-3.0-only(根 package.json 明确声明) |
| Stars(发文时实查) | 35.6k(2026-09-24 实查,会变) |
| 适合谁 | 天天写、调提示词,又不想把草稿和 API Key 交给第三方网页的人 |
先交代一句:这篇我没有实际跑起来——它需要你自己配各家的 API Key。文中所有结论来自对源码(develop 分支)和官方文档的阅读,运行时体验不在讨论范围内。
它接的是个什么活
写提示词的麻烦不在写,在验证。同一句话换个模型,效果可能完全两样;凭感觉改,改完也不知道有没有变好。这个工具把这件事拆成了固定几步:先用 LLM 把你的提示词改写成结构化版本,然后让原稿和优化稿各跑一遍(可以换着模型、配着测试用例跑),LLM 当评委打分,两边并排对比,不满意就按反馈继续迭代,每条迭代链都有历史记录。
它对 system prompt 和 user prompt 是分开处理的,源码里是两套默认模板;多轮对话里选中的单条消息也能单独优化,走的是另一个入口。这个区分挺重要——调 Agent 的人主要改的是 system prompt,跟日常聊天用的 user prompt 优化思路完全不同。
扒开看:所谓优化,核心是一段元提示词
从源码看,一次优化的路径非常清楚。packages/core/src/services/prompt/service.ts 里的 optimizePrompt() 做三件事:resolveOptimizationMessages() 取模板、TemplateProcessor 把你的提示词渲染进模板、llmService.sendMessage() 丢给模型。流式版本走 sendMessageStream(),多回调一个推理 token 的通道。没有别的了。
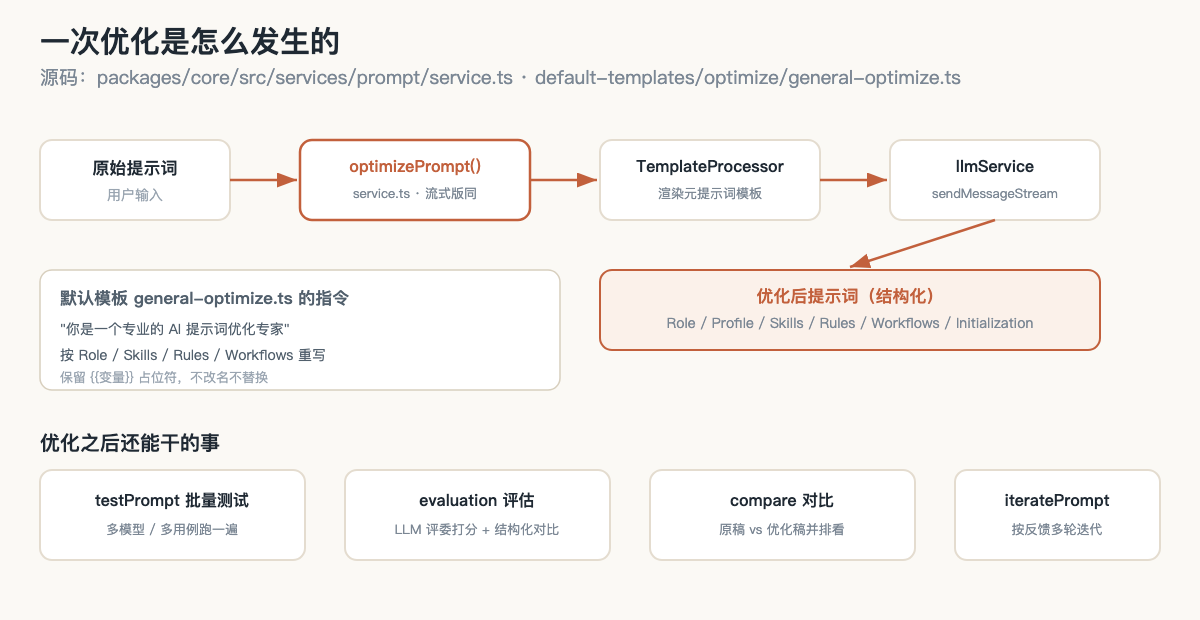
所以真正决定「优化质量」的,是模板本身。默认模板 default-templates/optimize/general-optimize.ts 开头一句是「你是一个专业的AI提示词优化专家」,然后要求按这个骨架重写:
// packages/core/src/services/template/default-templates/optimize/general-optimize.ts(节选)
content: `你是一个专业的AI提示词优化专家。请帮我优化以下prompt,并按照以下格式返回:

# Role: [角色名称]

## Profile
- language: [语言]
- description: [详细的角色描述]
- expertise: [专业领域]

## Skills
1. [核心技能类别]

## Rules
1. [基本原则]  2. [行为准则]  3. [限制条件]

## Workflows
- 目标: [明确目标]
- 步骤 1: [详细说明]

如果原始 prompt 包含双花括号变量占位符(例如 {{variable_name}}),
这些是后续运行时变量,必须在优化后的 prompt 中逐字保留,
不要改名、删除或替换成具体值。`
最后那句「逐字保留变量占位符」我印象很深——这是被坑过才会写进默认模板的句子,因为 LLM 改写时最爱干的事就是把 {{变量}} 当成没写完的内容替换掉。
模板不止一套。同目录下还有 analytical-optimize(分析式重写)、output-format-optimize(强调输出格式)、soul-hermes-compose 和 soul-openclaw-compose(角色扮演、人设类的组装模板),user prompt 另有 user-optimize 一套。迭代入口 iteratePrompt() 有个硬约束:模板必须是 message array 格式,否则直接抛 IterationError——因为迭代要往上下文里塞变量和工具定义,字符串模板装不下。
说穿了,优化就是模板工程:模板写得越讲究,改写越靠谱。好处是这套模板全开放,你可以在模板管理里改默认行为;上限则取决于你接的模型。
让我意外的其实是架构
我原本以为 35k star 靠的是「提示词优化」这个题材。读完架构部分,我的判断变了。
这是个 pnpm monorepo,engines 写死 node ^24.0.0,包拆成 core、ui、web、extension、desktop、mcp-server 六个。web 是 Vue 3 + Pinia + Tailwind,desktop 是 Electron,extension 是 Chrome 插件。关键信息在 core 的依赖清单里:
// packages/core/package.json dependencies(节选)
"@anthropic-ai/sdk": "^0.124.0",   // Anthropic 直连
"@google/genai": "^1.52.0",        // Gemini 直连
"openai": "^6.33.0",               // OpenAI 及兼容接口直连
"dexie": "^4.4.1",                 // IndexedDB,本地存储
"diff": "^8.0.4", "jsonrepair": "^3.13.3",
"mustache": "^4.2.0", "zod": "^4.3.6"
三家官方 SDK 加一个 IndexedDB 库,架构取向就摆在这了:调用从你的浏览器或桌面端直接打到模型服务商,中间没有服务器转一手;API Key、历史记录、模板全存本机。我用它跑提示词,草稿不会落到任何人的数据库里——包括作者自己的。
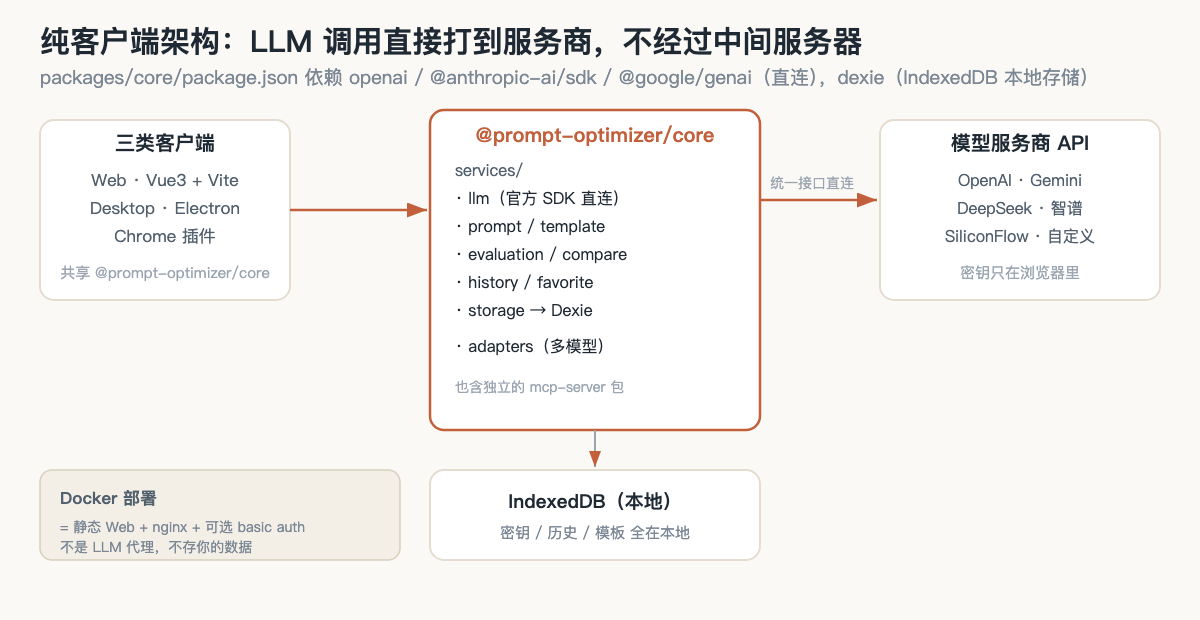
Docker 版印证了这一点:镜像里是静态 Web 页面加 nginx 反代,可选配一对 ACCESS_USERNAME/ACCESS_PASSWORD 做访问控制。它不是 LLM 代理,也不存你的数据。另外 Docker 启动后会在 /mcp 路径挂一个 MCP server,暴露三个工具——optimize-user-prompt、optimize-system-prompt、iterate-prompt,README 给了接进 Claude Desktop 的完整示例。等于这个工具同时是给 Agent 用的提示词服务。
还有个工程细节值得一提:根 package.json 里有个 check:no-chinese-runtime 脚本,从名字看是防止中文硬编码进运行时(界面文案走 i18n)的守门脚本;e2e 测试带 VCR 式的录制/回放模式,可以不真调 API 跑回归。这类洁癖在同类项目里不多见。
当然,取舍也要说清楚:调用在浏览器端发出,Key 就在浏览器里,公网部署时暴露面比有后端的方案大——README 里那个可选 basic auth 就是冲这个来的。公司内想多人共享提示词库,它也没有云端存储,历史各存各的浏览器。
它为什么涨得这么快
把几个时间点排一排(均已联网核对):2025-02-12 建仓;2025-07-31 上 GitHub 日榜时 11.3k+;2025-12-09 第三方统计 17.65k;2026-08-14 达 33.1k、项目健康度评分 88/100;2026-09-24 我实查 35,607。十九个月从零到 3.5 万,第三方目录把它排进 TypeScript 项目 star 前 5%。
涨得快的原因,把各家报道和 README 对起来看,大概是四件事:纯客户端架构踩中了「不想把提示词交给网页」的情绪;部署形态全,Web、桌面、插件、Docker、Vercel 随便挑;多模型不站队,OpenAI、Gemini、Anthropic、DeepSeek、Grok、智谱、SiliconFlow、OpenRouter、魔搭都能接,任意 OpenAI 兼容接口也行(README 里就有接 Ollama 的示例);再加 MCP 这个被 Agent 生态引用的入口。
还有一个叙事我觉得起了作用:README 和多篇报道都强调结构化提示词能激发小模型潜力。翻译一下——在成本敏感或本地部署的场景,优化提示词等于省钱。这个卖点比「帮你写好提示词」更能打动要控成本的人。
谁该用,谁可以绕开
| 场景 | 结论 |
|---|---|
| 天天写、调 system prompt 的开发者和 Agent 调试者 | 适合。迭代链、历史、对比这几个功能就是为这个循环造的 |
| 想在便宜模型上榨性能、控成本的个人和小团队 | 适合。注意调用走你自己的 Key,费用自付 |
| 不愿把提示词草稿交给第三方网页的 | 适合,这正是它的立身之本 |
| 要做数据集驱动的自动化调优、提示词回归测试进 CI 的 | 不适合。它的测试面板是交互式的,这类需求 promptfoo 那类框架更对口 |
| 团队要云端共享提示词库、多人协作的 | 不适合。本地优先没有云存储,历史各存各的设备 |
一句话总结:把它当成「提示词的本地 IDE」更贴切——优化按钮只是这条流水线的起点,测试、评估、对比、迭代才是它值钱的部分。