上个月我在算一笔账。我们有一条三十来步的注册加开通流程,早先是 Playwright 写的,选择器一散就得跟着改;后来交给模型去点,选择器是不用维护了,可每跑一次 CI 就是三十来次模型调用——一个 PR 跑一遍,一天几十个 PR,模型账单涨得比测试通过率还快。
问题其实不在模型贵。在于我们把最贵的方式,用在了最便宜的事上。第一次让 agent 摸清界面,那是真探索,钱该花;第二次、第三十次,界面一个字都没改,我们还在让它重新摸一遍。
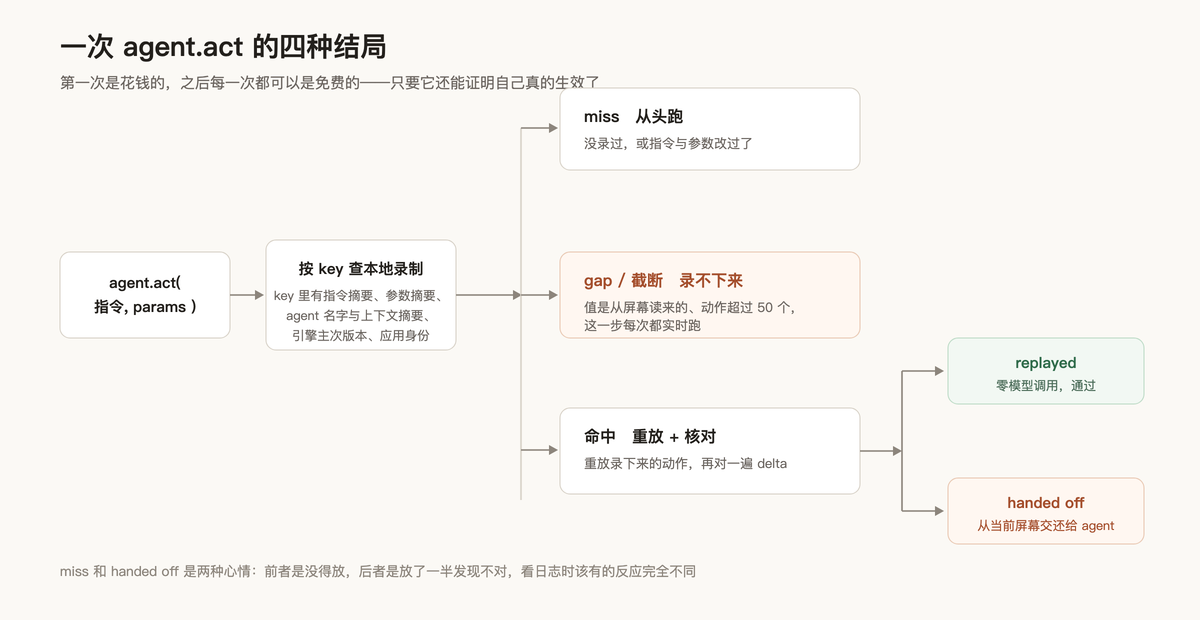
这周 GitHub 热榜第一的那个项目就在治这个毛病。它叫 e2e,TesterArmy 开源,把同一件事切成两半:agent 走过去的那一遍,等后面的断言验收通过,就把动作录下来;下一次跑同一段,直接重放,一次模型都不叫。只有重放对不上——页面改了、控件换了名字、结果没重现——才把控制权还给 agent。
| 项目名片 | 信息 |
|---|---|
| 项目地址 | github.com/tester-army/e2e |
| 官网 / 文档 | tester.army/e2e;仓库 docs/ 下 49 个页面,随 npm 包一起发出去 |
| 主要语言 / License | TypeScript / Apache-2.0 |
| Stars(发文时实查,会变) | 5,011,fork 212,25 位贡献者(2026-10-06 查 GitHub API) |
| npm | e2e 0.17.0(2026-10-04 发布);近一周下载 60,933 次 |
| 适合谁 | 已经在用 Playwright 或 Cypress、手上有几条「选择器三天两头改」的核心流程想交出去的前端与测试团队;以及需要 Web 与移动端共用一套 API 的团队 |
贵的那一次只做一次
它的 API 长得跟 Playwright 很亲近,一个测试文件里混三种步骤,只有一种要花钱。
| 步骤 | 怎么写 | 要不要调模型 |
|---|---|---|
| 目标 | agent.act('把工作区升级到 Pro') | 要,除非缓存命中重放 |
| 断言 | agent.assert / waitFor / extract | 每次都要 |
| 定位器 | screen.getByRole / expect | 不要 |
README 里那段示例基本把用法讲完了:
// tests/checkout.e2e.ts
import { test, expect } from 'e2e';

test('a member upgrades to Pro', async ({ app, agent, screen }) => {
  await app.open('/settings/billing');

  await agent.act('upgrade the workspace to the Pro plan');
  await agent.assert('the invoice preview shows a prorated amount');

  await expect(screen.getByRole('status')).toContainText('Pro');
});
注意第二行和第四行是两种不同的东西。agent.act 是让模型自己想办法,agent.assert 是让模型看一眼屏幕回答一个是非题。按照 docs/cache.mdx 的说法,assert、waitFor、extract 永远实时跑,只有 act 会被录下来重放。
但录制不是白给的。一段 act 想进缓存,后面必须跟一步能独立校对结果的检查,而且这份检查得是它认的那几种:locator 的 matcher、expect(browser).toHaveURL()、locator.waitFor()、agent.assert()、agent.waitFor() 都算;普通值的 expect(value).toBe()、expect.poll、agent.extract,以及「整条测试最后过了」都不算。
这条规矩看起来啰嗦,实际是在逼你写测试时多写一行断言。我反而觉得这是全篇最值得记的一条设计:它不给「测试绿了所以这一遍大概没问题」留后门。
回放要过三道闸
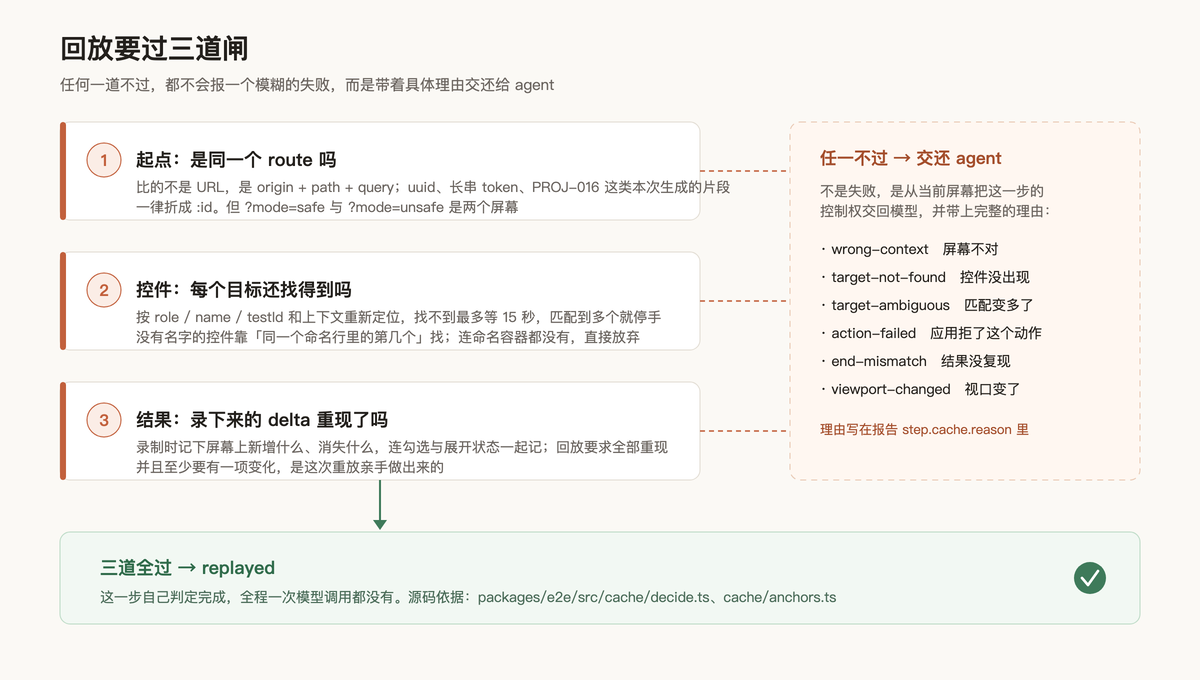
真正让我愿意花一晚上读它源码的,是它怎么判断「这次重放到底算不算数」。这个判断拆成三道闸,任何一道不过,都带着理由交还给 agent。
第一道是起点。回放前它先问:应用现在停的屏幕,是不是录制开始的那个屏幕。这听着简单,坑在于它比对的是 route,不是 URL(packages/e2e/src/cache/route.ts:160)——origin 加 path 加 query,其中所有「像是这次记录才生成的」片段会被折成占位符 :id:uuid、hex 和纯数字串、十二位以上字母数字混排的 token、PROJ-016 这种前缀加两位以上数字的 ID,都算。于是 /orders/42?t=1727780000 和 /orders/7?t=1727780999 是同一个屏幕;但 ?mode=safe 和 ?mode=unsafe 不是,/companies 和 /companies?tab=notes 也不是。
第二道是控件。录下来的每个动作都存了目标的描述符,回放时按 role、name、test id 和上下文重新找过去;找不到就等,最多 15 秒;匹配到多个就停手。这里有个处理我觉得挺实在:没有名字的控件,可以靠「同一个命名行、列表项或分组里同类型的第几个」来找;如果连个命名容器都没有,跟它长得一样的兄弟又太多,它直接放弃回放、把这一步交回 agent,不赌。
第三道是结果,也是整套东西里最讲究的一处。录的时候它不只记动作,还记这一段的「变化」——屏幕上新增了什么、消失了什么,连勾选、展开、按下的状态一起记(src/cache/anchors.ts,这个 delta 叫 anchors)。回放时这三样都得重现。而且它还追一句:这些变化里,至少得有一项是这次重放真的做出来的(同文件里的 deltaEvidenced)——否则一个提交之前就已经写着「Submitted」的状态,什么也证明不了。
还有三个细节,只有翻到源码才看得到,但都很关键。
- 每次都会变的文本不会进锚点。日期、时钟、时长、「12 位以上字母数字混排」这类看着像随机 ID 的长串,在
anchors.ts里是一组写死的正则;纯数字的角标(比如未读数「11」)直接不用。带名字的计数是另一回事:「3 records imported」「Showing 1 to 9 of 9 results」算结果本身,必须重现;而本来就在屏幕上、只是从「41 items」变成「42 items」的那种,不算。 - 该记的优先记。
alert、alertdialog、status这几个「应用自己在宣布结果」的角色排最前面,然后是叶子节点,容器排最后——因为容器的无障碍名往往就是子节点的拼接,在列表页里会把真正说明结果的那一行挤出名额。每侧最多留 8 个(MAX_TRACE_ANCHORS = 8,src/cache/trace.ts:49)。 - 回放时冒出一个录制时没见过的 alert,直接判停。应用自己跳出来的报错,比任何匹配都更能说明「这次跟录的那次不是一回事」。
它也会主动认输,这点我很喜欢
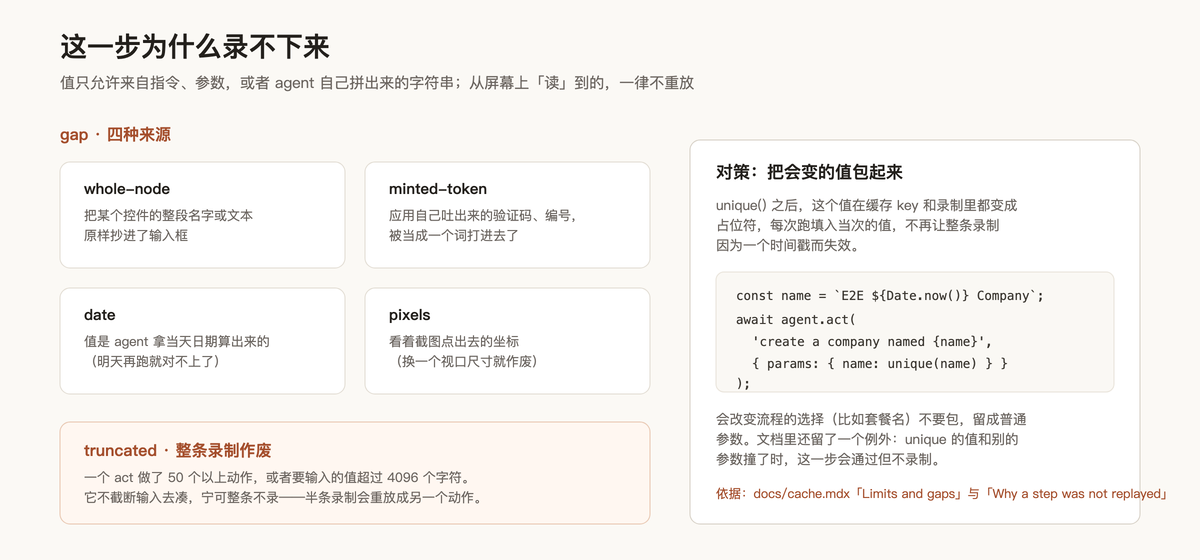
一套能自动回放的系统最怕的不是失败,是假装成功。e2e 在「哪些东西根本录不了」这件事上写得很坦白:从屏幕上读出来、而不是从指令或参数里拿到的值,一律进不了缓存,因为它下次读到的可能不一样。它给这类情况起了个名字叫 gap,还分了四种来源——整段抄下来的文本、应用自己生成的码或 ID、靠当天日期算出来的值、以及看着截图点出来的坐标。
除此之外,一次 act 超过 50 个动作、或者要输入的值超过 4096 个字符,这条录制会被标记成截断,同样不重放。这两种情况按它的说法,只有把动作预算调到 50 以上才会碰上。
想让它录得下来,办法是把会变的值包一层 unique():
import { unique } from 'e2e';

const name = `E2E ${Date.now()} Company`;
// 包起来之后,这个名字在 key 和录制里都变成占位符,
// 每次跑填入当次的值,而不是让整条录制因为一个时间戳而失效
await agent.act('create a company named {name}', { params: { name: unique(name) } });
await expect(screen.getByRole('heading', { name })).toBeVisible();
它连「怎么区分是没录过还是录过但对不上」都想到了。停第一个动作之前就停,算 miss;开始重放之后才停,算 handed off——前者是没得放,后者是放了一半发现不对,两种情况在看日志时的心智完全不同。报告里 step.cache.reason 会给出具体原因,一共十几种,从「没录过」到「目标变多了」「结束时对不上」,每种都配了一句「该怎么办」。
它的账,是真自己算过的
我对「开源项目自称省 token」这种话一向打问号,所以专门去找了它自己怎么用。答案是它把狗粮吃到位了。
仓库里有两个私有基准项目 apps/web-benchmark 和 apps/mobile-benchmark,专门放硬界面场景——shadow DOM、canvas、iframe、原生弹窗、被键盘盖住的提交按钮、虚拟列表、WebView。它们各自的 agent 套件,把回放缓存目录 .e2e/cache/ 直接提交进了仓库;CI 以只读模式跑这些录制,遇到没有录制的步骤才调模型。移动端那套在 iOS 模拟器和 Android 模拟器上都跑。项目的 AGENTS.md 里写得很直白:这样这两个套件就能以「确定的成本和速度」卡住一个 PR。
更狠的是下一句。web benchmark 的 agent 任务带上了 --strict-cache:如果一条录制还在、但已经放不出来了,这一步会直接以 REPLAY_STALE 失败(退出码 2,而且不重试),而不是悄悄去调模型把账单继续烧下去。这份默认行为在文档里也留着——录制悄悄失效时,测试照样绿,模型照样烧钱,直到有人去重新录;--strict-cache 就是把这件安静的事变吵。
顺带说一个它顺手做得挺清楚的地方:录制想共享,就把 .e2e/cache/ 从 .gitignore 里放出来提交;不想共享,就留在本地各录各的。但缓存文件不是无害的——里面存了明文输入值,只有 secret 会被替成名字。文档里那句提醒挺到位:把录制当测试数据一起评审。另外 CI 默认是只读的,想让 CI 写缓存得显式打开。
对编码 agent 的友好度也值得记一笔。它的 CLI 里有一个 e2e mcp,Claude Code、Cursor 这类工具能直接接管一个真在跑的会话去读屏幕、跑步骤;npm 包里还塞了完整的文档和一个 agent skill,npx skills add tester-army/e2e 就能装进项目。这跟之前拆 Anthropic 那份插件文件夹约定是同一个思路:把「怎么用我」也做成可版本化的文件。
这周才突然火起来,原因有一半不在代码里
建仓时间是 2026 年 7 月 22 日,但它的曲线不是慢慢爬的。10 月 5 日两份中文榜单的快照都还在 3,200 星上下(第三方整理,我没逐条复核原始榜单),到 10 月 6 日我实查已经是 5,011——一天多涨掉了一千八。两天前它还只是「有个挺聪明想法的新项目」,现在是热榜第一。
团队背景解释了其中一半。TesterArmy 是 Y Combinator 2026 年春季批的公司,拿了 120 万美元 pre-seed,投资方名单里有 Vercel 的 Guillermo Rauch、Expo 的 Charlie Cheever、Cognition 的 Walden Yan、Resend 的 Zeno Rocha。Rauch 转发他们的发布推文时写了一句后来被反复引用的话——「The future is verification-engineering」,未来的验证工程里有些测试是确定性的,有些是 agent 的。这句话基本就是这个项目想占的位置。
另一半是团队本身的成色。三位创始人来自波兰,Szymon Rybczak 是 React Native 社区里出名早的贡献者,Oskar Kwaśniewski 是主提交者——654 个提交里他一个人占了大头;贡献者名单里还有几个 React Native 生态里眼熟的名字。两个半月、757 个 PR、117 个 issue,这个节奏很难是三个人手工干出来的,仓库里跟 Devin 那个 bot 有关的提交也在,他们自己也承认在重度用编码 agent 开发这个项目。
我提这段不是想给热度加分,是想说明一件事:热度来自传播和团队,别把它直接读成代码成熟度。这一点在我读源码的过程中是反过来的——它的设计比传播里那句「不用调模型了」要细得多,但也确实还在长。0.15 到 0.17 三个版本只花了 5 天。
什么情况我劝你别上
说好的要泼冷水。下面这些是我认为动手前得先想清楚的。
| 场景 | 我的结论 |
|---|---|
| 想一上来就把整套回归改成自然语言 | 别。第一次跑每一条都要真调模型,先把最烦的那几条挪过来,让它录完再谈扩大 |
| 指望 CI 自动维护录制 | 默认不行。CI 里缓存是只读的,要写必须显式打开 cache: 'read-write' |
| 团队没人愿意看录制文件 | 慎用。录制里有明文输入值(只有 secret 存名字),它是该进 code review 的测试数据,不是无害的产物 |
| 要测安卓上手机会自己刷新的界面 | 现在别。10 月 4 日提的 issue #841 里,一个每秒更新数值的列表,每次读屏要 20 到 40 秒,偶尔直接撞上 adb 的 30 秒超时;同样的测试在 iOS 上很快 |
| 要求 API 一年不动 | 不行。还在 0.x,README 自己写着小版本之间 API 和配置都可能变。想稳就锁死版本,并且按它的提示预期维护成本 |
| 不想让 CLI 上报任何东西 | 它默认发匿名遥测(命令、引擎、失败位置,不含测试内容),npx e2e telemetry disable 或 E2E_TELEMETRY_DISABLED=1 关掉 |
| 已经在用 Playwright 或 Cypress | 这一类反而最值得试。官方给了 Playwright、Cypress、Selenium、Detox、Maestro 五份迁移文档,定位器和断言不用重写,只把最脆的几条换成 agent.act |
最后说一句我看完之后最服气的地方,它跟 AI 没多大关系。测试录制回放这件事本身不新鲜,二十年前就有了,一直没人敢用,是因为录下来的东西太脆,页面一动就废。e2e 花了大功夫的地方,是给「这次重放到底有没有真的生效」找一个能自动判断的答案——录下变化、回放时核对变化、还要求至少一处变化是这次亲手做出来的。这套账算清楚了,agent 才敢只在第一次出现。
至于它值不值得现在就上生产 CI,我的判断是:值得为「探索」付一次钱,不值得为「回归」重复付钱。它恰好把这两件事分开了,这个位置以后大概会被很多框架抄走。