先说结论:awesome 值得收藏,但别把它当工具书用。sindresorhus/awesome 这个仓库没有一行能跑的代码,主体就是一份 866 行的 readme.md 加几份规范文档,却常年待在 GitHub star 榜最前排(第三方榜单普遍把它排进全站前十,aiec.fun 2026-09 的统计是全球第 7)。我这次把它当「软件」拆了一遍——readme 逐段过、几份「宪法」逐条读、CI 脚本逐行看——想搞清楚两件事:一份链接列表凭什么顶流十二年,以及今天拿它入门还顺不顺。
| 项目名片 | 信息 |
|---|---|
| 项目地址 | github.com/sindresorhus/awesome |
| 主要语言 / License | 无代码(纯 Markdown)/ CC0-1.0 |
| Stars(发文时实查) | 511,874(2026-09-29 实查,会变) |
| 适合谁 | 要进陌生领域先看地图的开发者;想研究知识整理与社区运营方法论的人 |
它不存内容,只管筛选
很多人第一次打开 awesome 都会有个疑问:代码在哪?没有。它是一个「关于清单的清单」:readme.md 按 26 个大类摆了 617 个一级条目(我在源码里数的,另有 5 条挂在 Related 区),每条就是一行链接加一句话,指向一个独立的 awesome-* 仓库——awesome-python、awesome-go、awesome-selfhosted 这些你多半见过,它们全是从这里长出来的。
所以它解决的不是「资源在哪」,而是「怎么从海量资源里把好的捞出来」。GitHub 搜索的噪音不用我多说:拿 awesome 当关键词,现在能搜出五万多个仓库(aiec.fun 2026-09 的数据);光被打上 #awesome-list 话题的就有九千多个(daily.dev 统计 2026 年 4 月是 9,259 个)。「awesome-」前缀早就从一份清单变成了社区默认的命名约定——新建资源集合仓库,很多人下意识就这么起名。
awesome 根索引自己只做两件事:告诉你哪个领域有一份公认的清单,然后把你送到那份清单门口。真正装着工具和教程的,是下游那几百个子仓库。
真正值钱的是那几份 .md
这是我读下来最大的意外:awesome 真正的产品不是列表,是「什么算一份好清单」的明文标准。仓库里四份文档分工很清楚——awesome.md 是宣言,pull_request_template.md 是收录门槛,contributing.md 和 create-list.md 是操作手册。
宣言里最重要的一句就埋在开头(awesome.md:9):
Only awesome is awesome. Research if the stuff you're including is actually awesome... You should rather leave stuff out than include too much.
宁可少收,不能收滥。这句话定了整个生态的调子:策展,不是收集。这也是它和那些「欢迎自荐、来者不拒」的资源仓库最本质的区别。连协议都替你想好了——清单推荐用 CC0,并明说 MIT、GPL 这类代码协议不适用(awesome.md:71),毕竟清单是文字作品不是代码。
收录门槛(pull_request_template.md)琐碎到近乎苛刻,开头还写着一句很不像官方文档的话:"Don't waste my time."(:17)。我挑几条硬的:
- 清单至少存活 30 天才能提交(:44),create-list.md 里还专门叮嘱先养一个月再报;
- AI 生成的清单不收,AI 生成的 PR 也不收(:15、:45);
- 仓库名必须是小写短横线的 awesome-name-of-list,默认分支必须叫 main(:55、:47);
- 条目描述首字母大写、以句号结尾、不许出现清单自己的名字(:30),写法都给你规定了;
- 不收区块链主题(:39),没有商量余地。
最有意思的是第 91 行:为了确认提交者真的读完了这份长清单,它要求你在 PR 里只评论一个词——unicorn。对,独角兽。读到这里我笑出来了,这很 Sindre Sorhus。
还有一条在我看来是整套机制的支点(:18-19):提交者必须实质评审至少 4 个其他开放 PR,只回一句「looks good」不算数,得真指出问题。想把自己的清单送进索引,就得先帮别人把清单做好。这一条把 awesome 的维护成本摊给了每一个受益者,也是它十二年没塌的根本原因——不是靠热情,是靠机制。
一条会自己去克隆你的 CI
规范写得再严,靠人盯也盯不过来。awesome 的解法是把门禁塞进 CI,而且只盯一件事:readme.md 的变更。workflow 定义(.github/workflows/main.yml)里有 paths 过滤,只有动了 readme.md 的 PR 才触发 lint job。
触发之后跑的是 repo_linter.sh,逻辑简单到让我愣了一下:
# .github/workflows/repo_linter.sh(节选)
# 先从 PR 的 diff 里抓出形如 https://xxx#readme 的链接
REPO_TO_LINT=$(git diff origin/main -- readme.md |
  (grep ^+ || true) |
  (grep -Eo 'https.*#readme' || true) |
  sed 's/#readme//')
...
if [ -z "$REPO_TO_LINT" ]; then
  echo "No new link found in the format:  https://....#readme"
else
  mkdir -p cloned
  cd cloned
  git clone "$REPO_TO_LINT" .   # 第 21 行:克隆那份被提名的清单
  npx awesome-lint              # 第 22 行:用官方 linter 校验它
fi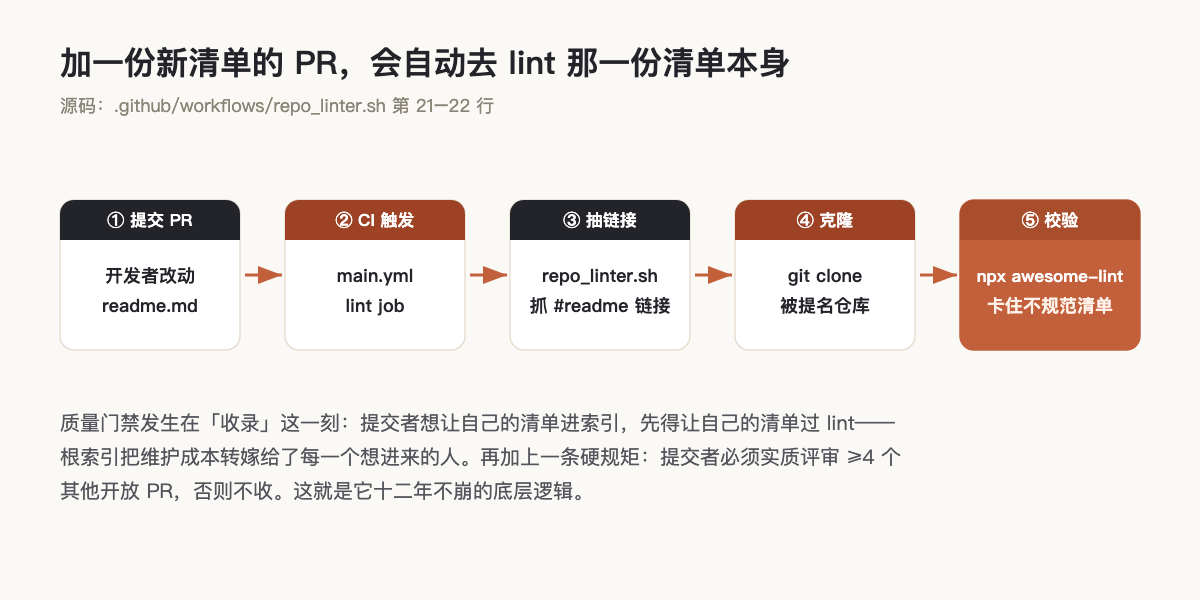
也就是说,加一份新清单的 PR 提上来,CI 会自动去克隆那份清单本身、当着所有人的面 lint 一遍;lint 不过,PR 就悬在那。质量门槛被前移到了「收录」这一刻,维护者只需要看结果。我的第一反应是:这招替维护者省下的人工 review 不可估量。
凭什么 51 万 star
光看数字是反直觉的:GitHub API 里这个仓库的 language 字段是空的——因为它确实没有代码。511,874 star(2026-09-29 实查)、37,148 fork、CC0-1.0 协议,一个 Markdown 仓库坐在这个位置上,本身就说明 star 榜早就不是「代码写得最好」排行榜。
有个第三方观察我觉得说到点子上了(top10.dev):GitHub star 前几名——awesome、freeCodeCamp、public-apis——没有一个是能安装的库,全是「参考材料」。星标衡量的东西变了:从代码实用性变成了规范性,大家收藏的不是工具,是一份可以反复引用的权威入口。
awesome 能占住这个位置,两层原因。一是网络效应:越多人把新清单按它的规矩建、往它的格式上靠,它作为「总入口」的价值就越大——整个 awesome- 命名约定养出来的生态,反过来都在给它投票。二是作者本人:Sindre Sorhus 是 npm 上最高产的作者之一(第三方统计普遍说 200 多个包),这份清单挂在他名下,规范本身就有信用背书。
我的判断是:它一半的 star 是给「awesome 这个格式」的,另一半是给「把收录标准写成明文」这件事的。后者才是真正可以偷师的部分。
我不建议的用法,和它的现状
三个提醒,都是我自己踩过或查证过的。
第一,别当工具书用。根索引太宽,它是「领域地图」不是「工具箱」——从索引到子清单再到具体工具要跳两层。想找某个具体库,直接搜更快;它服务的场景是「我要进一个完全陌生的领域,先看地图」。
第二,收录不等于还在维护。根索引只在收录那一刻卡质量,之后不追踪子清单的新鲜度。拿 star 数判断一份清单过没过时是错的——star 只涨不掉。daily.dev 的建议我认同:看 last commit 和贡献者活跃度,比 star 靠谱得多。
第三,它的现状值得知道:仓库描述里明确写着 PR 暂停收录——原文是 "Pull requests are temporarily disabled until I have a chance to catch up with the existing ones"。API 里 open issue 有 106 个,最后一次提交是 2026-09-02 的 "Meta tweaks"。单人维护的瓶颈是真实存在的,哪怕机制设计得再聪明。也正因如此,「评审换收录」那条规矩现在回头看,更像是提前打好的补丁。
| 场景 | 结论 |
|---|---|
| 进入陌生领域前建立「领域地图」 | 适合,先翻对应大类,从子清单进 |
| 研究知识整理 / 社区运营方法论 | 适合,那几份 .md 是活教材,尤其是「评审换收录」 |
| 直接找某个具体库 | 不适合,多两层跳转,直接搜索更快 |
| 把收录当作时效性保证 | 不适合,收录不等于仍在维护,要看 last commit |
awesome 教会我的不是「去哪找资源」,而是:把标准写成明文、把维护成本摊给受益者、把质量检查交给机器。一份 866 行的 Markdown 能顶流十二年,靠的是这三件事,跟代码没关系。