我想给手上几个项目补一批架构图,试过几轮「让 AI 直接画图」:同一段描述跑两次,出来的拓扑不一样;图是挺好看,但拿去评审没人敢当真。翻到 Archify 的时候,它的分工让我停了一下——Agent 不画图,只写一份 JSON,画图和校验全部交给一个确定性程序。本来想 clone 下来真跑一遍再写,结果卡在网络上,这件事先讲清楚。
它到底解决什么问题
Archify 是一个以 Agent Skill 形式分发的工具,支持 Raven、Cursor、Claude Code、Codex CLI、opencode 这类宿主。它要处理的是「Agent 画的图不可信」这个具体毛病:Agent 每次凭感觉摆位置、连箭头,图看着合理,但节点之间到底有没有这条关系,谁也说不准。
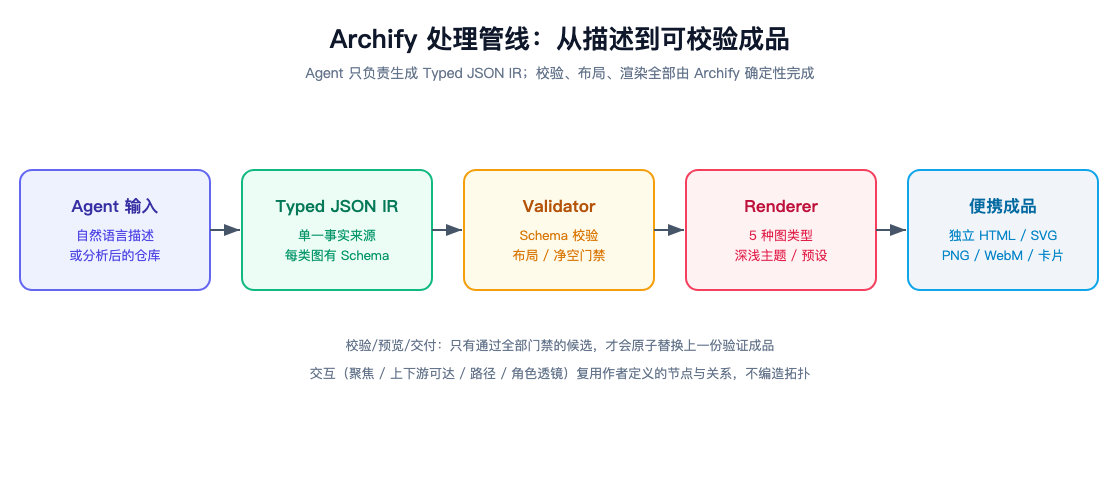
它的做法是切一刀。Agent 只负责把你嘴里的系统,或者一个真实仓库,翻译成一份带类型的中间表示(Typed JSON IR);剩下的校验、布局、渲染、交付,由 Archify 自己的程序确定性地做完。这样做的好处很直接:Agent 的产出变成了一份可以被程序检查的结构化数据,而不是一坨只能靠肉眼看的 SVG。
它覆盖五类图:Architecture(组件、服务、存储、边界)、Workflow(CI/CD、审批、工具调用)、Sequence(调用顺序、缓存回源、鉴权)、Data Flow(数据管线、血缘、PII)、Lifecycle(状态、重试、终态)。这五类各自有独立的 JSON Schema,字段不通用。
源码是什么结构
仓库根目录下有一个 archify/ 子目录,工具本体在这里,骨架不复杂:
archify/package.json—— 版本2.17.0-dev.1,bin指向./bin/archify.mjs,engines要求 Node.js >= 18。archify/bin/—— 有四个入口:archify.mjs(主 CLI)、preview.mjs(本地实时预览)、visual-check.mjs、open-artifact.mjs。archify/schemas/—— 五个图的 schema,加一个共享的common.schema.json。archify/examples/—— 每种图都有一份可直接改的 JSON 源文件,比如web-app.architecture.json。
让我有点意外的是依赖清单:package.json 里根本没有 dependencies 字段,只有四个 devDependencies(ajv、parse5、saxes、simple-icons),而且都是拿来构建、跑测试用的。scripts 里的 render:examples、check:validators、test 全是在开发和发版时跑,成品 Skill 到了使用者手上就是一个纯 Node 程序,不需要 npm install 才能用。对一个号称要装进各种 Agent 的工具来说,这个取舍挺关键:少一层运行期依赖,就少一类装不上的情况。
Typed JSON IR 长什么样
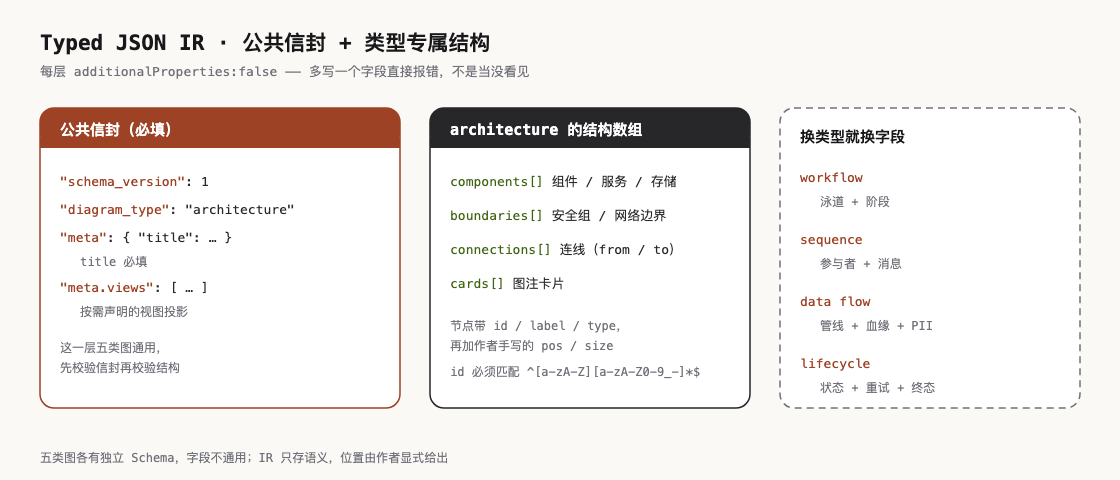
Schema 说明文档把 IR 的契约写得很直白:每份文件都要有 schema_version、diagram_type、meta(其中 title 必填),再带上各自的结构数组。Architecture 用的是 components / boundaries / connections;Workflow 用泳道加阶段;Sequence 用参与者和消息。
拿仓库自带的 web-app.architecture.json 举例,去掉冗长部分后大致是这样:
{
  "schema_version": 1,
  "diagram_type": "architecture",
  "meta": {
    "title": "Sample Web App",
    "quality_profile": "showcase",
    "views": [
      { "id": "request-path",
        "label": "Primary request path",
        "focus": ["users", "cdn", "lb", "api", "db"] }
    ]
  },
  "components": [
    { "id": "api",   "type": "backend",  "label": "API Server",
      "sublabel": "FastAPI :8000", "pos": [670, 300], "size": [130, 60] },
    { "id": "cache", "type": "database", "label": "Redis",
      "sublabel": "cache :6379", "pos": [670, 150], "size": [130, 60] }
  ],
  "boundaries": [
    { "kind": "security-group", "label": "sg-api :443/:8000",
      "wraps": ["lb", "api"] }
  ],
  "connections": [
    { "id": "cache-read-through", "from": "api", "to": "cache",
      "label": "read-through", "fromSide": "top", "toSide": "bottom" }
  ],
  "cards": [
    { "dot": "cyan", "title": "Edge",
      "items": ["CloudFront CDN fronts all traffic"] }
  ]
}你会看到位置是作者自己给的坐标(pos 和 size),不是自动布局算出来的。这正是它跟通用自动布局工具的分歧点:谁在这张图上讲故事,谁就决定哪个组件放中间、哪条线要突出。Archify 只负责把共享的端点、走向、净空这些机械部分确定性展开,避免多条箭头堆在同一个中点。
有一点设计得很硬气:schema 在每一层都设了 additionalProperties: false。意思是你在节点上多写一个 colour 字段,校验会直接报错,而不是当没看见。ID 也有约束,必须匹配 ^[a-zA-Z][a-zA-Z0-9_-]*$,共享定义放在 common.schema.json 里。
校验与交付:失败也要能修
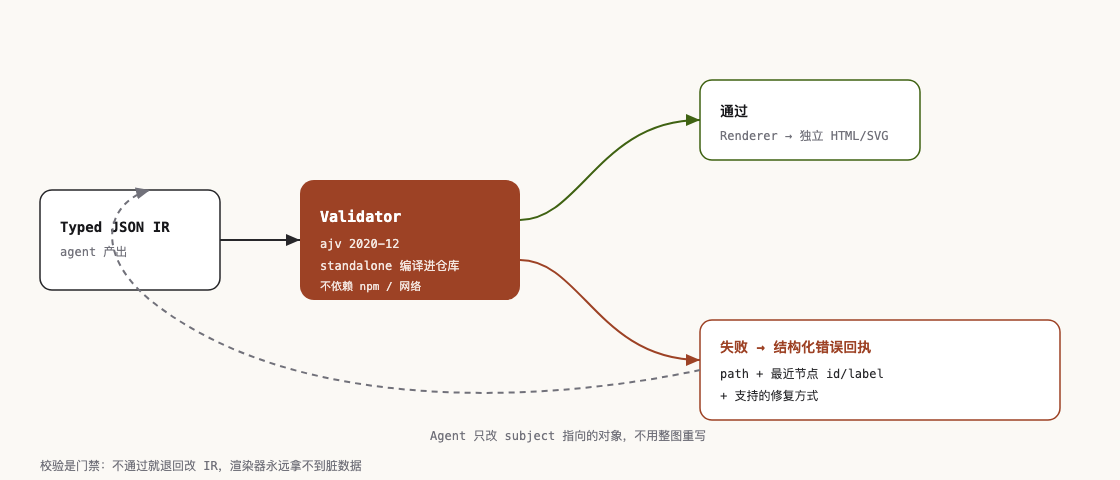
IR 先过校验,再过布局,这个顺序写在 schema 说明里。校验器不是运行时才去装的:开发时用 ajv 的 draft 2020-12 standalone 生成器(strict: true、allErrors: true)编译成 renderers/shared/generated-validators.mjs,把生成物提交进仓库、随 Skill 一起发出去,所以运行期校验不依赖 npm 也不依赖网络。npm test 的作用之一就是检查生成物有没有跟 schema 漂移。
它给 Agent 留的修复回执是我比较欣赏的部分。校验失败时输出的是结构化错误,像这样:
workflow schema validation failed:
  /nodes/3 (id/label: "router") must NOT have additional properties
    {"additionalProperty":"colour"}
报错给出了出错的路径、最近的节点 id 或 label、到底哪个字段不被接受,以及支持的修复方式。Agent 只需要改 diagnostics[] 里 subject 指向的那个对象,不用整图重写,也不至于从 Node 的堆栈里瞎猜。交付环节同理,候选图要通过全部校验、布局、净空门禁,才会原子替换掉上一份可信成品;中途写坏的文件不会污染你上次的好图。
安装与常用命令
官方给的安装方式是一行:
npx skills add tt-a1i/archify -g装好之后,在对话里描述系统就行,源码仓库里给的命令清单是这样的:
# 环境自检
node bin/archify.mjs doctor

# 生成一份 demo
node bin/archify.mjs demo /tmp/archify-demo

# 不确定用哪类图,让它推荐
node bin/archify.mjs guide "展示带 Redis 缓存未命中的 API 请求"

# 校验一份 IR,--json 拿到结构化回执
node bin/archify.mjs validate workflow examples/agent-tool-call.workflow.json \
  --quality showcase --json

# 交付并打开
node bin/archify.mjs deliver workflow examples/agent-tool-call.workflow.json \
  /tmp/workflow.html --quality showcase --open --json
这些命令我没能本机验证
老实说,上面这段是照着 README 和 package.json 的 bin 字段整理的,不是我自己跑出来的。这台机器上 git clone 被代理挡了,报的是 CONNECT tunnel failed, response 502,换 HTTP/1.1 也一样。所以我只拿到了 README、package.json、schema 说明和一个示例 IR,没有真的 node archify.mjs doctor 看过输出。文章的结论建立在这些源码和文档上,命令行为以官方文档为准;等网络通了我会补一段真跑的记录。
值不值得用
| 场景 | 结论 |
|---|---|
| 用 AI 生成架构图/时序图,但要能评审 | 合适。IR 可校验、可 diff,比「AI 画的图」可信得多 |
| 做 PR 评审、前后架构对比 | 合适。内置 compare 子命令,输出已校验的 Before / Delta / After |
| 要一个能拖拽的在线绘图工具 | 不合适。WYSIWYG 编辑器明确不在产品范围内 |
| 想把已有 Mermaid 图一键搬过来 | 不合适。自动 Mermaid Parser 不在范围内 |
| 想要一个托管分享服务 | 不合适。它只保证产出一个独立 HTML 文件,托管得自己解决 |
再补两个我认为值得知道的边界。一是定位,「Archify 不是通用绘图编辑器,也不是 Mermaid 主题」,这句话来自它的 README,我认同一半:它确实解决的是「技术意图怎么变成可交流的成品」,但代价是你得先接受它的技能栈。脱离 Agent 手写那份 JSON,等于用坐标画图,体验不会比直接拖鼠标好。
二是它的更新检查。安装后的 Skill 带一个低频、失败静默的发布检查,最多弹一条可选更新提醒,绝不自行下载或安装;请求只访问一个固定的 stable.json,不发本地版本、项目数据或设备标识,设了 ARCHIFY_UPDATE_CHECK_DISABLED=1 可以整个关掉。这种「默认克制」在工具类项目里不多见,值得记一笔。
我的判断
截至 2026-09-20 的 GitHub API 数据,这个仓库 4 月才建,star 已经到 6.7 万量级、fork 4525,主语言 JavaScript,MIT 协议。这个增速对一个偏工程向的工具来说挺少见。真正让我记住它的不是流行度,是那个「让 Agent 少干一点、让程序多干一点」的取舍:把不确定的部分(生成结构化数据)留给模型,把确定的部分(校验、布局、渲染)留给代码。顺着这个思路,Agent 出的图至少能进入 review 流程,而不是只能当插画看。
一句话总结:如果你需要的是「能被校验、能被 diff 的架构图」,Archify 值得花半小时读一遍它的 schema;如果你想要的是随手拖拽出好看的图,它会让你失望。